 立 档
谁是敌人,
谁是朋友。
每一帧,都有出处。
Every frame has a file.
原文是一篇政论文,不是小说,没有现成的剧情和对白。拆解的工作是:找出论证主线,把每一个阶级落到一个可拍的人物和场景上,再把长句压成短视频能听清的旁白。
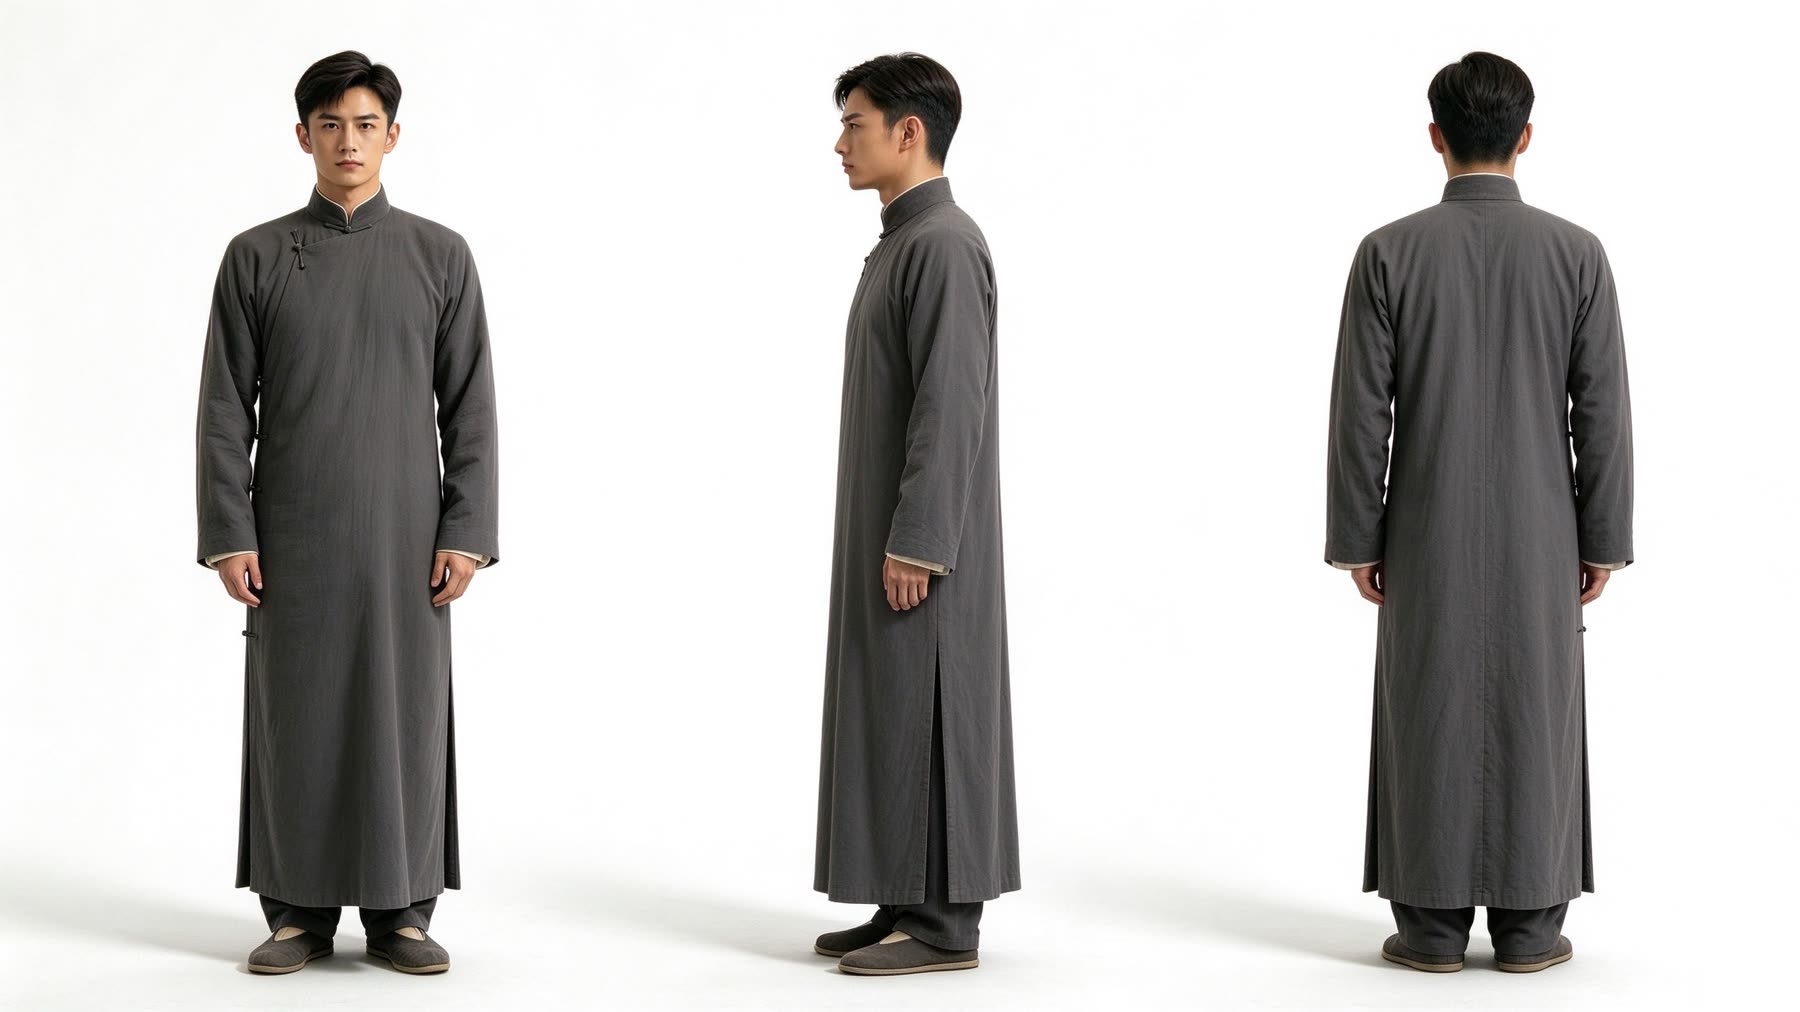
JD-1熟读文本,根据导演要求拆分剧本内容所有角色、群像、场景共用一套模板风格词,每个资产只追加一句“差异句”,保证 6 段视频里的人物和美术风格一致。角色统一纯白背景、标准 A-Pose、全身入镜,出图后做成三视图,作为图生视频的参考。
JD-2结合分镜头脚本制作资产、文生图、图生视频同一条提示词会出好几张候选图。挑选看三件事:是否符合 1920 年代的服装考据,A-Pose 和全身构图是否标准,脸能不能撑起后面多个镜头的特写。选中的那张再去做三视图。
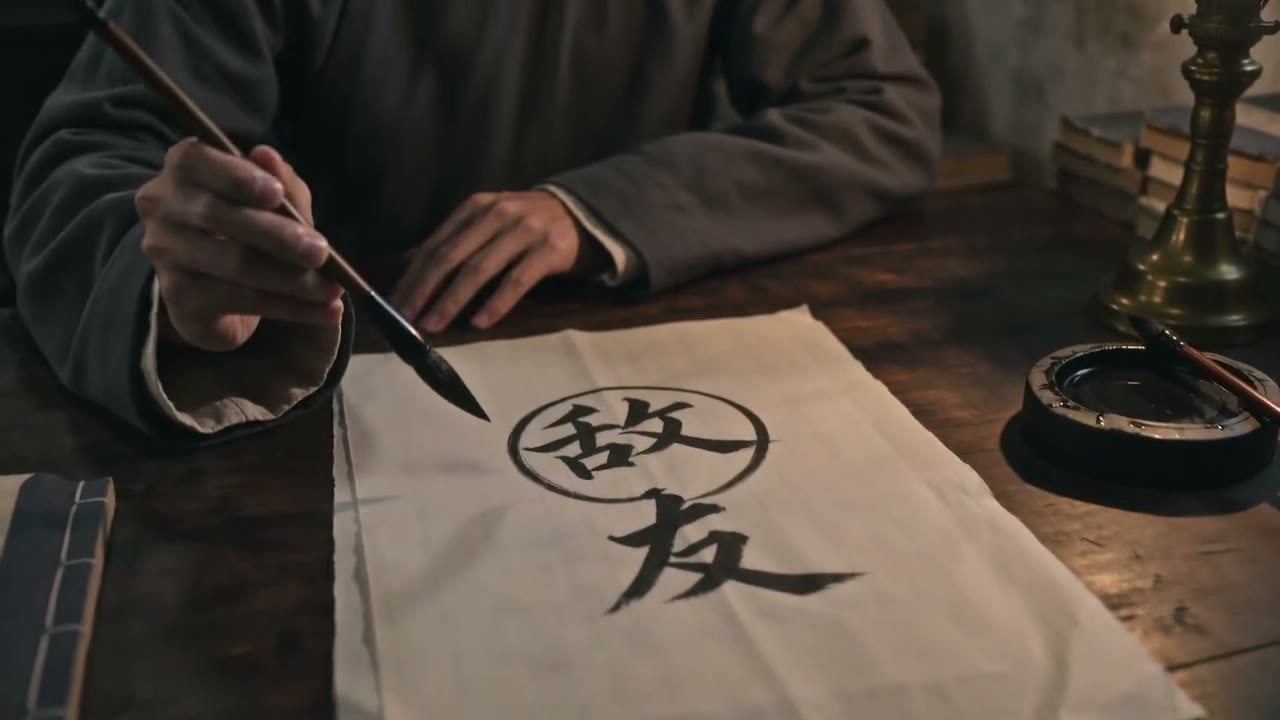
加分项抽卡 → 剪辑全流程左边是图生视频的成片,右边是对应的分镜脚本。点任意一个分镜,视频会跳到那一镜;下面的时间线是整片 90 秒的结构,点任意位置也能跳转。
6 段视频各 15 秒,按脚本时间码拼接。旁白、音效都在脚本阶段就写进了每个分镜,剪辑时按轨道对齐。不满意的镜头回到抽卡环节重新生成,而不是硬剪。
JD-3剪辑自己生产的视频素材,并配合导演要求修改6 段 × 15 秒,对齐分镜表的起止秒数。
每镜的旁白和音效在脚本里已写好,按轨道对位。
逐镜记录问题:节奏、造型、穿帮、台词。
画面问题回到抽卡重生成,节奏问题在剪辑里改。
这一页的全部内容来自同一个项目:从一篇 4000 多字的原文,做到一条 90 秒的 AI 真人短剧。